
table of contents
從單點故障談起:為什麼我堅持「主要+雙備援」的模型架構
說真的,那次經驗到現在想起來還讓我背脊發涼。上週二深夜,我正趕著一份隔早要交的市場分析報告,依賴的主力付費模型突然顯示「服務暫時不可用」。螢幕上的轉圈符號無情地旋轉,我的腦筋也跟著當機,眼看截止時間逼近,那種束手無策的焦慮感簡直讓人窒息。從那一刻起我就明白,在 AI 應用的世界裡,單點故障絕對是致命傷,把身家性命全押在單一模型上,無異於在沙灘上蓋大樓。
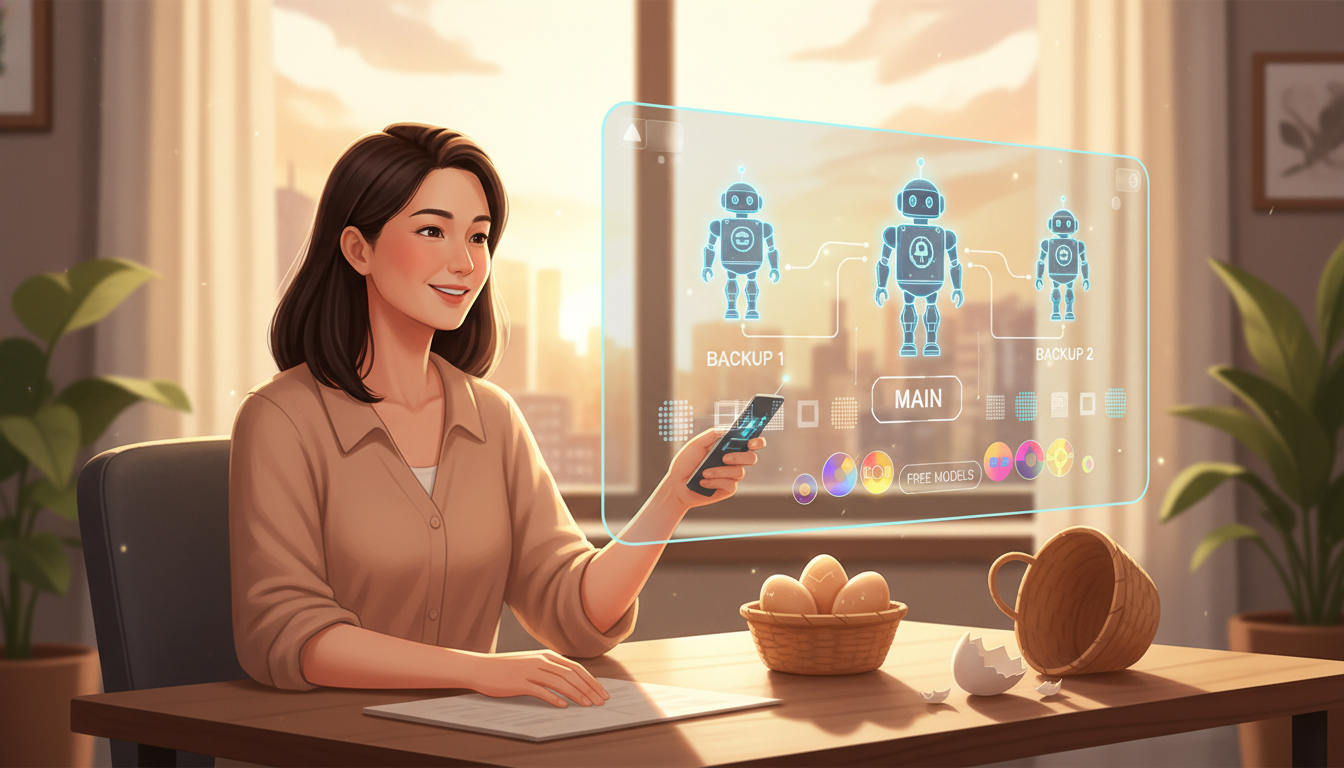
痛定思痛後,我徹底重構了自己的機器人架構,堅決採用「1 主 2 備」的策略。這並不是為了省那幾塊錢的 API 費用,老實說,穩定性才是企業運作的命脈。我選擇 OpenRouter 作為核心整合平台,就是看中它能讓我像切換頻道一樣,無縫在不同模型間快速轉換。一旦主模型出現延遲或掛點,系統能自動無感切換到備援模型,確保服務永不中斷。這種架構帶來的安心感,是任何單一頂級模型都無法比擬的。
在備援模型的選擇上,我特別引入了高品質的免費模型作為第二、第三道防線。只要帳戶內維持基本的儲值額度,每週就能享有驚人的免費用量。像是 GLM 4.5 Air 擁有超大上下文窗口,非常適合處理長篇對話;而 DeepSeek R1 的推理能力則能應付複雜的邏輯分析。我將這些模型分級配置,T1 級別的拿來做日常主力備援,T2、T3 則針對圖文分析或特殊場景待命。這不僅是資源的最大化利用,更是為我的 AI 團隊買了一張永不失效的保險。
現在我的系統裡運行著十三個 Agent,七個付費模型衝鋒陷陣,六個免費模型嚴陣以待。這種混合架構讓我不再擔心單一廠商的政策變動或技術故障。記得上次又有模型波動時,我的機器人絲毫無感地切換到備用軌道,繼續流暢地回答用戶問題。那一刻我深刻體悟到,真正的智慧不在於模型有多強大,而在於架構有多韌性。別把雞蛋放同一個籃子,這句老話在 AI 時代依然是黃金法則。
免費午餐真的能吃飽嗎?深度解析 OpenRouter 的額度機制與隱藏規則
,我徹底重構了自己的機器人架構,堅決採用「1 主 2 備」的策略。這並不是為了省那幾塊錢的 API 費用,老實說,穩定性才是企業運作的命脈。我選擇 OpenRouter 作為核心整合平台,就是看中它能讓我像切換頻道一樣,無縫在不同模型間快速轉換。一旦主模型出現延遲或掛點,系統能自動無感切換到備援模型,確保服務永不中斷。這種架構帶來的安心感,是任何單一頂級模型都無法比擬的。
在備援模型的選擇上,我特別引入了高品質的免費模型作為第二、第三道防線。這裡有個關鍵門檻大家一定要知道:只要你的帳戶儲值超過 10 美金,每週就能解鎖高達 1000 次用量的免費額度。說真的,剛看到這個規則時我也半信半疑,心想免費的午餐能吃飽嗎?但實際跑過數據後才發現,這些免費模型的反應速度和邏輯能力完全超乎想像。像是 GLM 4.5 Air 擁有超大上下文窗口,非常適合處理長篇對話;而 DeepSeek R1 的推理能力則能應付複雜的邏輯分析,絲毫不輸付費等級。我將這些模型分級配置,T1 級別的拿來做日常主力備援,T2、T3 則針對圖文分析或特殊場景待命。這不僅是資源的最大化利用,更是為我的 AI 團隊買了一張永不失效的保險。
不過話說回來,天下沒有永遠不變的規則。OpenRouter 的免費額度機制其實相當動態,官方隨時可能根據伺服器負載調整各模型的可用量。我曾經就遇過某個熱門模型突然縮減額度的情況,幸好我有分散風險,才沒讓機器人當場罷工。所以我的建議是,千萬不要只盯著單一模型薅羊毛,而是要建立一個包含 GLM、Llama、Qwen 等多種架構的混合池。現在我的系統裡運行著十三個 Agent,七個付費模型衝鋒陷陣,六個免費模型嚴陣以待。這種混合架構讓我不再擔心單一廠商的政策變動或技術故障。記得上次又有模型波動時,我的機器人絲毫無感地切換到備用軌道,繼續流暢地回答用戶問題。那一刻我深刻體悟到,真正的智慧不在於模型有多強大,而在於架構有多韌性。別把雞蛋放同一個籃子,這句老話在 AI 時代依然是黃金法則。
T1 梯隊精選:那些免費卻強大到讓人懷疑人生的頂級模型
說真的,剛看到 OpenRouter 這個「存 10 美金送千次免費用量」的規則時,我心裡其實蠻懷疑的。心想免費的午餐能吃飽嗎?會不會只是些智力低下的模型拿來湊數?但實際跑過數據後才發現,這些免費模型的反應速度和邏輯能力完全超乎想像,簡直是挖到寶了。特別是 T1 梯隊那幾位選手,強大到讓人忍不住想問:廠商真的不會虧本嗎?我將它們分級配置,T1 級別的拿來做日常主力備援,這不僅是資源的最大化利用,更是為我的 AI 團隊買了一張永不失效的保險。
先來說說我的日常對話主力——GLM 4.5 Air。這款模型最讓我驚豔的不是它的智商,而是它那大得誇張的每週額度。你知道的,日常對話最吃資源,若是用付費模型,稍微聊嗨一點,餘額就噴得讓人得心驚肉跳。但 GLM 4.5 Air 完全不同,它擁有超大的上下文窗口,我曾經試著丟给它一篇萬字長文加上幾十輪的追問,它不僅沒崩潰,還能精準抓住前面的細節進行回應。那種「隨便用、不用省」的爽快感,讓我直接把它設為第一順位的預設模型。老實說,現在我大部分的閒聊和基礎資訊查詢,都交給它處理,穩定度之高,讓我幾乎忘了它其實是免費的。
但你知道嗎?真正讓我下巴掉下來的,是 DeepSeek R1 在複雜推理上的表現。之前遇到需要多步驟邏輯推演的難題,我通常會乖乖掏錢叫 OpenAI 的 o1 出場。但這次我抱著試試看的心態,把同樣的數學證明題和程式架構分析丟給 DeepSeek R1。結果你猜怎麼著?它展現出的深度思考過程,那種一層層剝開問題核心的邏輯鏈,簡直跟付費版的 o1 如出一轍。它不會急著給答案,而是會先自我辯證、修正錯誤,最後導出嚴謹的結論。那一刻我真的有感,原來免費模型在特定領域已經能跟頂級付費玩家平起平坐了,這對於需要大量運算卻預算有限的開發者來說,絕對是福音。
至於程式碼撰寫方面,gpt-oss-120b 則是另一個隱藏版的超級武器。身為一個常要跟 Bug 搏鬥的部落客,我對寫程式的模型特別挑剔。這款開源版的 GPT 模型,在 MMLU 測試中拿下了驚人的分數,實際用起來更是順手。我試著讓它重構一段混亂的 legacy code,它不僅快速理解了原本的邏輯,還給出了優化建議,甚至自動補上了註解。那種程式碼的「語感」非常接近 GPT-4,完全不像是一般免費模型那種生硬的翻譯感。說到這個,我後來才明白,所謂的備援策略,不只是為了防止服務斷線,更是為了在不需要花費高昂成本的情況下,也能享受到頂級的算力資源。
不過話說回來,天下沒有永遠不變的規則。OpenRouter 的免費額度機制其實相當動態,官方隨時可能根據伺服器負載調整各模型的可用量。我曾經就遇過某個熱門模型突然縮減額度的情況,幸好我有分散風險,才沒讓機器人當場罷工。所以我的建議是,千萬不要只盯著單一模型薅羊毛,而是要建立一個包含 GLM、Llama、Qwen 等多種架構的混合池。現在我的系統裡運行著十三個 Agent,七個付費模型衝鋒陷陣,六個免費模型嚴陣以待。這種混合架構讓我不再擔心單一廠商的政策變動或技術故障。記得上次又有模型波動時,我的機器人絲毫無感地切換到備用軌道,繼續流暢地回答用戶問題。那一刻我深刻體悟到,真正的智慧不在於模型有多強大,而在於架構有多韌性。別把雞蛋放同一個籃子,這句老話在 AI 時代依然是黃金法則。
特殊任務的特種部隊:多模態分析與海量處理的 T2、T3 模型應用
但你知道嗎?光有通用型的對話高手還不夠,當任務場景切換到需要「睜開眼睛」看世界時,就得請出我們的特種部隊了。這就是我架構中 T2 層級的特殊存在——Nemotron Nano 12B VL。說真的,一般模型丟張發票或手寫筆記進去,往往只能瞎猜或拒絕處理,但這款由 NVIDIA 打造的多模態模型,在 OCR(光學字元辨識)與圖文理解上的表現簡直是降維打擊。我有一次需要批量整理幾百張模糊的活動簽到表,試著丟給它處理,它不僅精準識別出潦草的字跡,還能分析表格結構,直接輸出整理好的 JSON 數據。那種對視覺資訊的敏銳度,讓它成為我處理文件自動化流程中不可或缺的關鍵拼圖,專門負責那些需要「眼力」的硬仗。
至於面對海量數據的狂轟濫炸,這時候就得靠 T3 層級的怪獸來撐場了。必須特別提一下 TNG DeepSeek R1T2 Chimera,這個模型的每週免費額度高達 80.6B tokens,誇張到讓我第一次看到時還以為是小數點標錯了。這麼庞大的吞吐量,拿來做日常聊天簡直是殺雞用牛刀,但若是用在大规模批次處理任務,它就是無價之寶。上個月我為了訓練自己的知識庫,需要讓 AI 預讀並摘要超過五千篇技術文章,若是用付費模型,帳單絕對會讓我心臟病發;但切換到 Chimera 後,我讓它連續跑了整整兩天,硬是把這座數據大山給啃了下來,而且額度還沒見底。這種「大力出奇蹟」的能力,正是備援策略中應對突發大量需求的底氣所在。
其實,建構這套系統的核心心法,就在於根據任務屬性進行靈活調度。我不會固定死誰要做什麼,而是建立了一套動態判斷邏輯:若是追求極致速度與即時回應,就指派輕量級的 Mistral 或 Haiku;若是需要高精度的邏輯推理或程式除錯,則優先呼叫 DeepSeek R1 或 GPT-oss;一旦涉及圖片分析或文件數位化,Nemotron 自動上場;而當面對如山般的數據清洗工作時,Chimera 就是最佳首選。老實說,這種按需分配的思維,讓我的機器人團隊不像是在單打獨鬥,更像是一支訓練有素的特種作戰小組。每個模型都在最適合它的戰場上發揮最大價值,既控制了成本,又確保了服務品質不會因為單一模型的瓶頸而打折。這才是我在實戰中摸索出來,真正具備韌性的 AI 生存之道。
重構我的 AI 軍團:從 7 人到 13 人的 Agent 編制擴張計畫
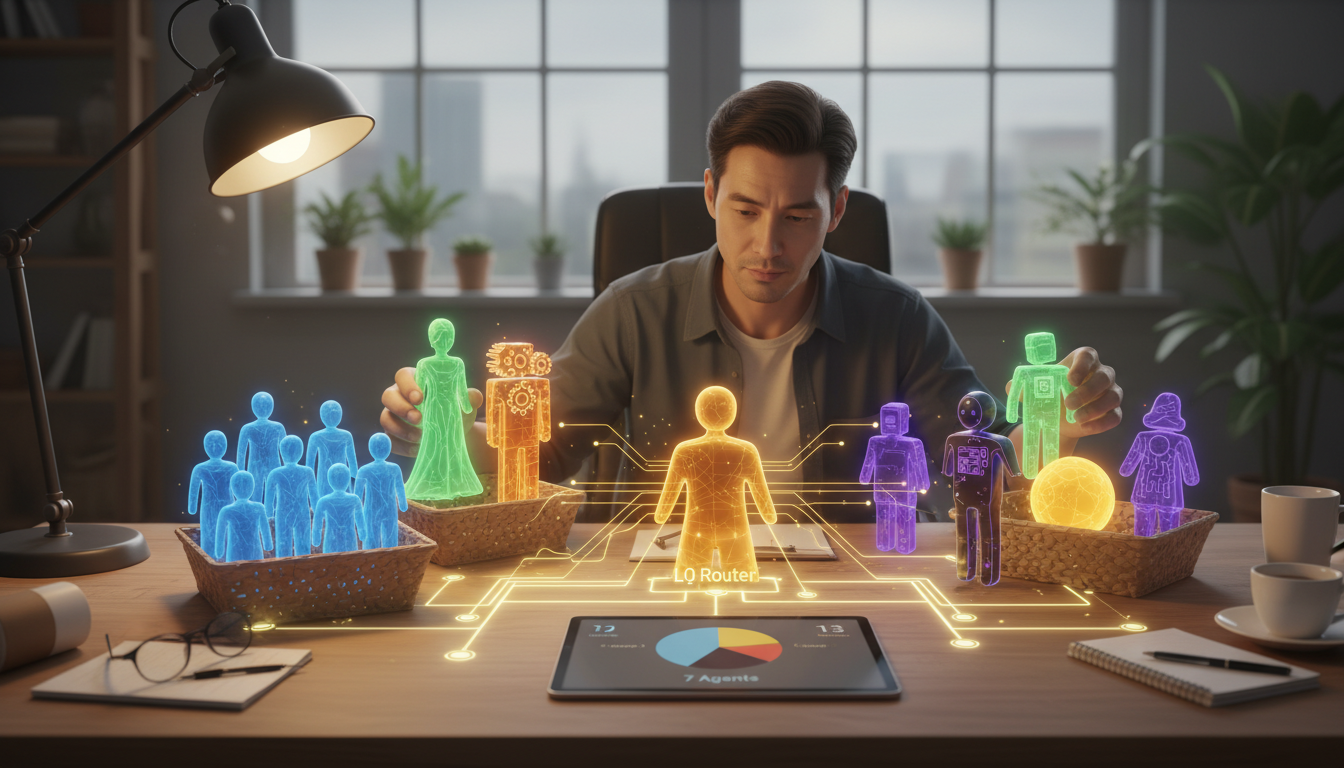
說真的,當我決定把原本精簡的 7 人付費特遣隊,一口氣擴編成 13 人的混合編制時,心裡其實蠻忐忑的。畢竟要管理這麼多不同性格的「數位員工」,若沒有一套嚴密的指揮系統,很容易變成一盤散沙。於是我引入了 L0 Router 作為總指揮官,它不直接處理具體業務,而是像個經驗老道的作戰參謀,負責在第一線判斷任務屬性,然後精準分發流量給最合適的 Agent。這讓整個系統從原本的「單點依賴」進化成「動態網狀結構」,就算某個付費模型突然抽風或額度耗盡,系統也能在毫秒間無縫切換到備用的免費模型,使用者根本察覺不到後台發生了什麼事。
這次新增的六位免費成員,各自都有極其鮮明的專長。首先是 GLM 4.5 Air,我把它定位為「日常對話手」,它那每週 52.4B 的超大額度,最適合用來應付那些瑣碎卻耗量的閒聊需求,讓昂貴的付費模型不用浪費在寒暄上。接著是 DeepSeek R1,這位「推理專家」擅長處理複雜的邏輯推演,當遇到燒腦的數學題或程式除錯時,它的能力完全不輸給頂級付費模型。而 gpt-oss-120b 則擔任「通用顧問」,在需要高品質回答但又不想消耗核心預算時,它總是能給出令人驚喜的水準。
視覺方面,我特別引入了 Nemotron Nano 12B VL 這位「視覺工程師」,它對圖片和文件的解析能力超乎預期,OCR 辨識準確度讓我相當驚豔,現在所有圖文分析任務都優先丟給它。至於前面提到的 TNG Chimera,自然就是負責「大量批次處理」的重裝兵,專門啃那些幾萬字的長文摘要。最後補上的 Llama 3.3 70B,則是一位穩健的「後備通才」,當其他模型都在忙碌時,它能隨時頂上維持服務不中斷。這十三位成員在 L0 的調度下,真的像是一支配合默契的特種部隊,每個人都守在最適合自己的戰位上。
回頭看這次架構重構,我最大的感觸是:備援不只是為了「防止當機」,更是為了「優化成本與效能」。過去我總覺得免費模型品質不穩,不敢委以重任,但實際跑過這幾個月的數據後,才發現只要放對位置,它們爆發出的戰鬥力簡直驚人。現在我的 AI 軍團,既有付費模型的鋒利,又有免費模型的厚實底氣,這種進可攻、退可守的彈性,才是我在這個快速變動的 AI 時代裡,最能安心的依靠。老實說,看著後台流量在不同模型間自如流動,那種掌控感真的超棒。
給想入坑朋友的真心話:打造高可用 AI 系統的心法與未來展望
說真的,走完這趟架構重構的旅程,我最想跟各位分享的一句話就是:千萬別把雞蛋放在同一個籃子裡。這不僅僅是老生常談的風險管理,在 AI 應用領域,這更是生存法則。回想剛開始設定時,我也踩過不少坑,最慘的一次是主要付費模型突然 API 超時,整個機器人直接當機,用戶端一片哀嚎。那時我才驚覺,單點依賴有多麼危險。後來我痛定思痛,引入了 OpenRouter 的免費模型作為備援,才發現原來「混合編隊」才是王道。
給想模仿這套架構的朋友一個真心建議:不要為了省錢而盲目堆疊免費模型,而是要根據「特性」來配置。我在實戰中發現,免費模型並非全是次級品,像 GLM 4.5 Air 這種大額度的模型,非常適合拿來做日常對話的緩衝;而 DeepSeek R1 這種推理強的,則是用來應對突發的複雜邏輯需求。設定過程中,最麻煩的是權重調整,一開始我設得太平均,導致高品質模型被濫用,後來改成「主要模型優先,免費模型兜底」的策略,系統穩定度瞬間提升。記得要隨時監控各模型的剩餘額度,避免关键时刻掉鏈子。
展望未来,我堅信「付費 + 免費」的混合模式將成為常態。現在的 AI 生態變化太快,今天的神級模型明天可能就過時,或是價格調整得讓人卻步。與其賭單一模型,不如建立自己的彈性系統。當你手中有十幾個不同特性的 Agent 隨時待命,那種從容不迫的感覺,是單一訂閱方案永遠給不了的。別再猶豫了,動手建立起你的備援系統吧,讓你的 AI 應用在風雨中也能穩如泰山,這才是玩轉 AI 的正確姿勢。


